Архитектура iGaming-платформы определяет, как работают учетные записи, игровые сессии, расчеты, платежи и операционная команда. От этих связей зависит, сможет ли онлайн-казино подключать новых поставщиков, выдерживать рост нагрузки и восстанавливаться после сбоев без потери истории операций. Мы проектируем платформу как систему с понятными границами ответственности, проверяемыми правилами обработки данных и управляемой стоимостью развития.
Работу начинаем с продукта и условий эксплуатации: рынков присутствия, количества брендов, состава интеграций, финансовой модели и доступности команды поддержки. Затем переводим требования в архитектурные решения, контракты API, схемы данных и сценарии отказа. Результат нужен разработчикам, владельцу продукта и эксплуатации: все участники должны одинаково понимать, где принимается решение, где хранится подтвержденный факт и кто отвечает за восстановление процесса.
Из каких компонентов состоит iGaming-платформа
Состав платформы удобно рассматривать через бизнес-возможности. Клиентские приложения показывают каталог, профиль и историю операций. Серверный слой проверяет доступ, выполняет команды и объединяет ответы внутренних систем. За ним находятся учет игроков, финансовый контур, интеграционные адаптеры, управление контентом, проверки и инструменты операционной команды. Инфраструктурные компоненты обеспечивают доставку событий, хранение, наблюдаемость и развертывание.
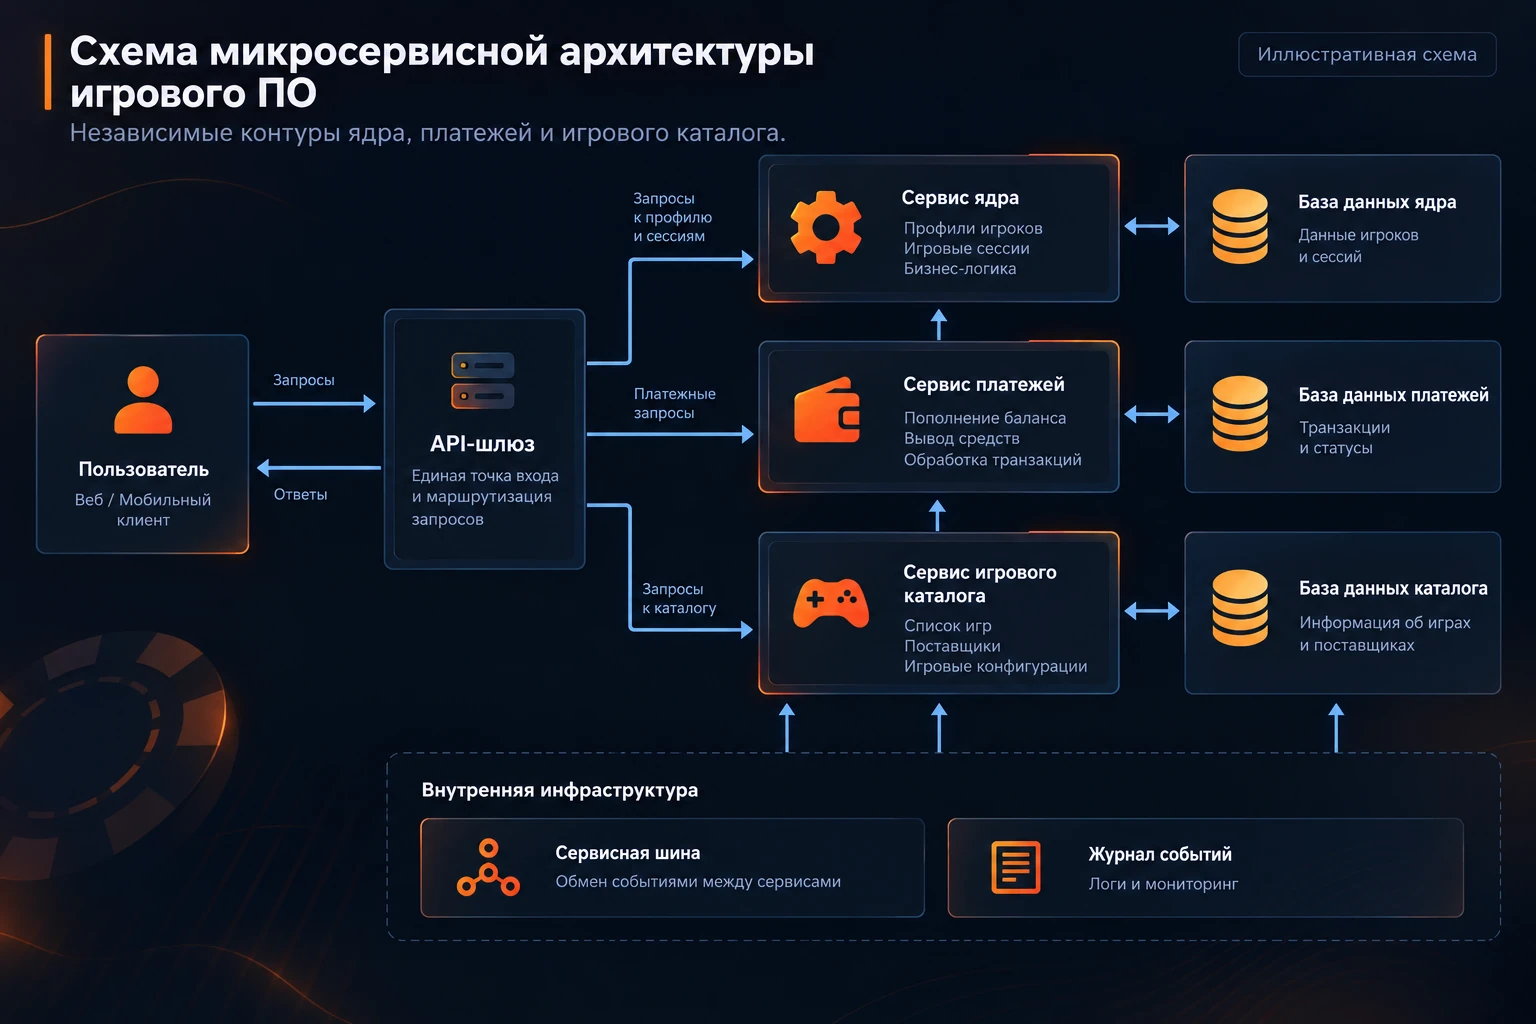
Граница модуля не обязательно совпадает с отдельным сервером. На старте несколько модулей могут работать в одном приложении, сохраняя собственные интерфейсы и владельцев данных. Важнее исключить неявные зависимости: например, каталог не должен напрямую менять финансовые записи, а маркетинговый сервис — самостоятельно снимать ограничения с игрока. Такие правила позволяют развивать систему без постоянного пересмотра всех остальных компонентов.
- Клиентский контур: сайт, мобильный интерфейс, API для пользовательских сценариев и управление сессиями.
- Транзакционный контур: учетные записи, денежные операции, игровые раунды и платежные процессы.
- Контур управления: back office, конфигурация брендов, доступность контента и журнал действий сотрудников.
- Контур контроля: KYC/AML, ограничения доступа, обработка рисков и передача случаев на рассмотрение.
- Контур данных: события, отчетные представления, аналитическое хранилище и техническая телеметрия.
Bonus Engine в общей архитектуре
Bonus Engine управляет жизненным циклом бонусного предложения: доступностью, активацией, применением условий и завершением. В архитектуре платформы это самостоятельная область правил, связанная с игроком, игровыми событиями и финансовым контуром. Ее задача — определить допустимое действие по конкретной версии предложения и передать результат через согласованный интерфейс. Денежный эффект при этом фиксируется системой финансового учета, а не произвольным изменением баланса внутри маркетингового модуля.
Для интеграции важны устойчивые идентификаторы, понятные статусы и обработка повторной доставки событий. Если сообщение о завершении раунда пришло повторно, правила не должны применяться второй раз. Если сервис временно недоступен, платформа следует заранее выбранному сценарию: откладывает обработку, ограничивает бонусный режим или показывает статус ожидания. Такое поведение согласовывается с продуктовой командой до запуска.
Хранить условия предложения следует вместе с версией, действовавшей при активации. Это помогает объяснить результат игроку и восстановить последовательность решений при спорной ситуации. На уровне общей архитектуры мы определяем границы сервиса, необходимые события, допустимую задержку и связь с аудитом. Механики начисления, условия отыгрыша и административные настройки рассматриваются отдельно: Bonus Engine для iGaming-платформы.
CRM и коммуникации
CRM использует данные о взаимодействии игрока с платформой для поддержки, сегментации и разрешенных коммуникаций. В общей архитектуре она получает подготовленные события и представления, а не свободный доступ ко всем рабочим базам. Это уменьшает связанность систем и позволяет контролировать состав передаваемых данных. Изменение шаблона сообщения или маркетингового сценария не должно влиять на подтверждение платежа и доступность игрового API.
Для обмена определяем идентификатор игрока, контекст бренда, тип события, время возникновения и версию формата. Отдельно передаем статусы согласий и ограничения коммуникаций. Перед отправкой сообщения необходимо учитывать актуальные запреты, поскольку ранее построенный сегмент может устареть. Сбой CRM обычно допускает отложенную доставку, однако порядок повторов и срок актуальности уведомления задаются для каждого типа сообщения.
Обратные команды CRM проходят серверную проверку прав и бизнес-правил. Сотрудник поддержки не получает возможность напрямую менять финансовые данные через карточку клиента. Значимые действия связываются с учетной записью сотрудника и журналом аудита. При проектировании также определяем, какие данные можно хранить во внешней системе и как выполнять их исправление или удаление в согласованных пределах. Подробнее об этом контуре: CRM для iGaming и интеграция коммуникаций.
Как взаимодействуют модули iGaming-платформы
Взаимодействие строится вокруг команд, запросов и событий. Команда просит выполнить действие: открыть сессию, создать платеж или изменить настройку. Запрос получает состояние без его изменения. Событие сообщает о факте, который уже произошел. Разделение помогает не перепутать намерение с результатом: сообщение о запросе вывода еще не означает, что деньги отправлены, а открытая игровая сессия не подтверждает завершение раунда.
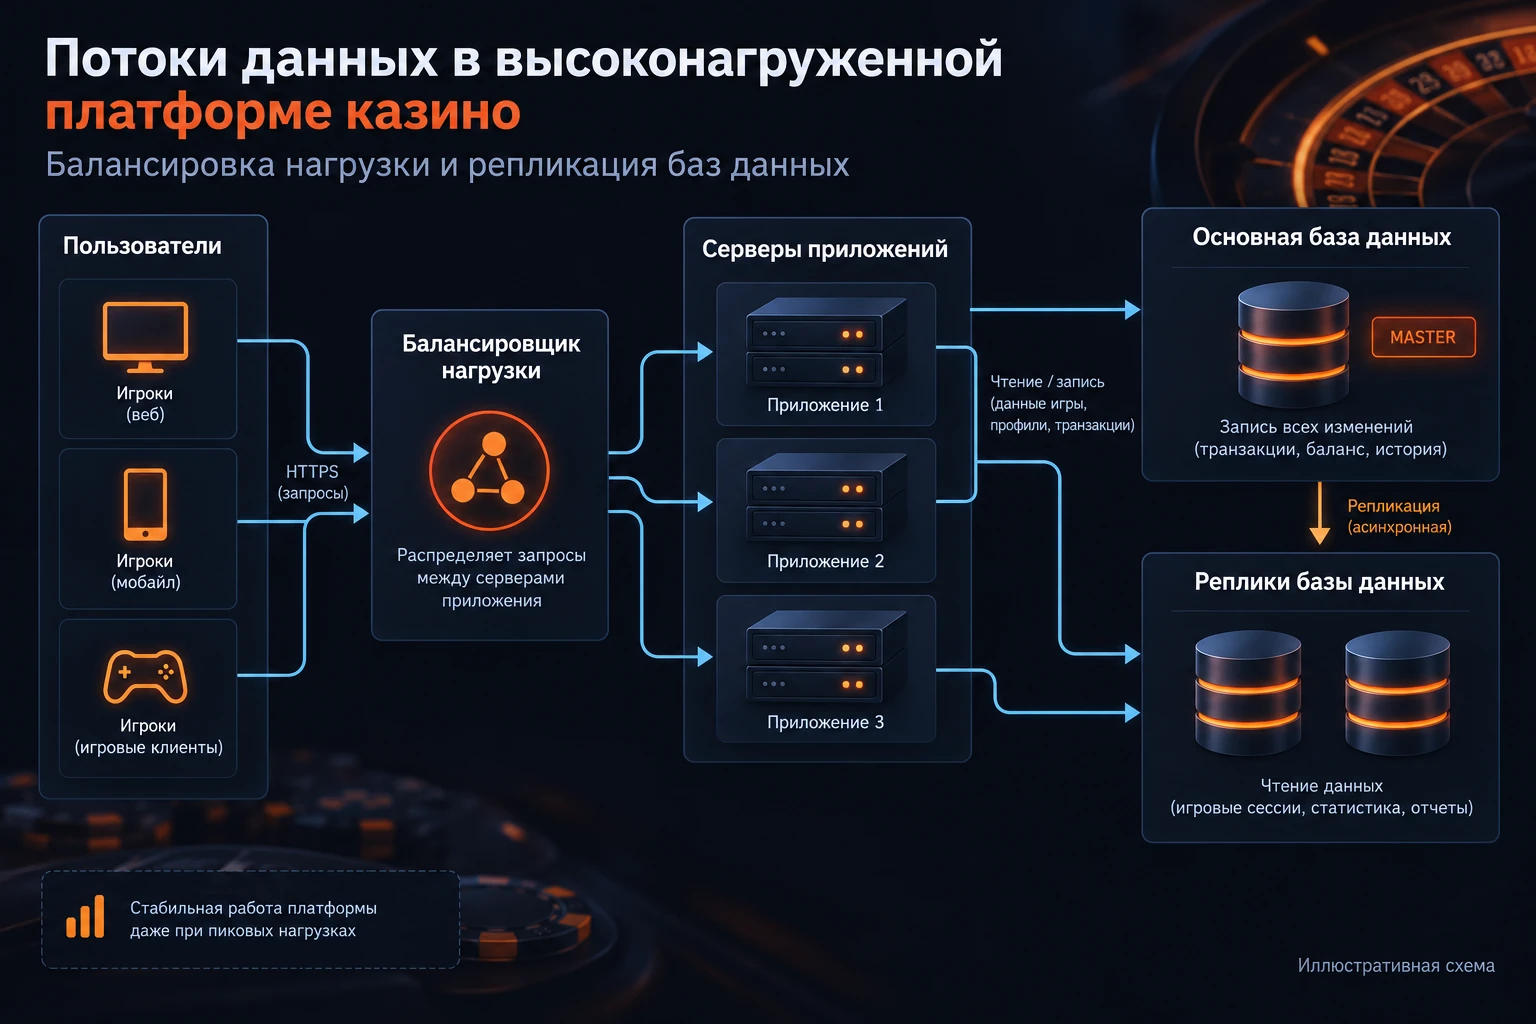
Для ответа пользователю используем синхронные вызовы там, где решение требуется сразу. Фоновые задачи, обновление отчетов и уведомления выполняем асинхронно, если бизнес-процесс допускает задержку. Длинная цепочка последовательных вызовов увеличивает время ответа и число точек отказа. Поэтому для каждой зависимости задаем бюджет времени, ожидаемые ошибки и поведение вызывающей стороны при недоступности получателя.
- Клиент отправляет запрос через серверный API.
- Платформа проверяет сессию, доступ игрока и доступность контента.
- Игровой адаптер создает сессию у выбранного поставщика.
- Операции раунда проходят проверку и финансовую обработку.
- Подтвержденные события поступают в отчетность и другие подписанные сервисы.
В этой последовательности у каждого шага есть собственное подтверждение. Если внешний поставщик ответил с задержкой, система не должна создавать новую независимую операцию только потому, что клиент повторил запрос. Идентификатор исходного действия связывает повтор с уже начатым процессом. Там, где итог неизвестен, вводится явное промежуточное состояние и процедура выяснения результата, а не автоматическое объявление операции неуспешной.
Межсервисный контракт описывает обязательные поля, допустимые переходы состояния, коды ошибок и правила совместимости. Контекст бренда и рынка передается явно и проверяется принимающим сервисом. Идентификаторы запроса, операции и внешнего сообщения сохраняются раздельно: один пользовательский запрос может породить несколько технических попыток, но бизнес-эффект должен оставаться контролируемым.
Для распределенного процесса назначаем владельца состояния. Он знает, какие шаги завершены, какие ожидают ответа и какие требуют вмешательства. Компенсация оформляется самостоятельным действием по бизнес-правилам; она не равнозначна откату общей транзакции во всех системах. Перед разработкой проверяем взаимодействие на сценариях задержки, повторного ответа, отмены и временного расхождения данных между представлениями.
Монолитная или микросервисная архитектура
Выбор между монолитом и микросервисами зависит от масштаба продукта, команды и требований к независимости изменений. Само количество сервисов не делает платформу надежной. Хорошо разделенный модульный монолит может быть подходящим стартом, если над системой работает небольшая команда, нагрузка предсказуема, а основные функции выпускаются совместно. В нем проще отслеживать выполнение запроса и поддерживать локальные транзакции.
При этом модульный монолит требует дисциплины. У каждого модуля должны быть понятные интерфейсы; доступ к данным соседнего модуля нельзя превращать в обычный способ интеграции. Разделение проверяется на уровне кода и зависимостей. Иначе приложение быстро становится системой, в которой изменение одной таблицы затрагивает игровые операции, административную панель и отчеты одновременно.
Микросервисы полезны, когда отдельные области действительно нуждаются в независимом масштабировании, выпуске или изоляции. Например, частое обновление каталога и тяжелая отчетность имеют другой профиль нагрузки, чем обработка транзакционных команд. Выделение адаптеров поставщиков позволяет ограничить последствия внешних сбоев. Но за автономность приходится платить сетевыми задержками, распределенной диагностикой и дополнительными процедурами восстановления.
| Критерий | Модульный монолит | Микросервисы |
|---|---|---|
| Развертывание | Общий выпуск приложения | Независимые выпуски при совместимых контрактах |
| Данные | Проще локальные транзакции | Нужны явные владельцы и согласование состояний |
| Масштабирование | Часто масштабируется приложение целиком | Можно отдельно увеличивать ресурсы сервисов |
| Эксплуатация | Меньше распределенных зависимостей | Больше требований к мониторингу и автоматизации |
Для растущего проекта часто подходит поэтапный путь. Сначала фиксируем доменные границы и контракты, затем измеряем нагрузку и частоту изменений. Выделяем сервис там, где есть подтвержденная причина: перегрузка, отдельная команда, особые требования к доступности или слишком большой радиус влияния релиза. Перенос выполняется постепенно, с проверкой маршрутизации запросов и согласованности данных.
Отдельно оцениваем готовность эксплуатации. Несколько десятков сервисов требуют управления конфигурацией, секретами, версиями API и очередями. Если эти процессы не автоматизированы, разработка может замедлиться даже при хорошей структуре кода. Архитектурное решение должно включать стоимость сопровождения, требования к дежурству и понятный способ локального воспроизведения ошибок, а не только красивую схему компонентов.
Event-driven архитектура iGaming
Event-driven подход связывает модули через события: изменение статуса проверки, завершение игрового раунда, подтверждение платежа или публикацию новой конфигурации. Производитель сообщает о факте, а подписчики решают, как его использовать. Благодаря этому добавление нового отчета не обязательно требует изменения сервиса, который обрабатывает исходную операцию. Однако асинхронность требует явно определить допустимое время доставки и последствия задержки.
Событие должно иметь идентификатор, тип, версию схемы, время возникновения и ссылку на бизнес-объект. Для диагностики полезны причинная связь с исходной командой и контекст трассировки. Полные документы игрока и другие чувствительные сведения не следует автоматически копировать в каждое сообщение: потребителю передается только необходимый набор данных, соответствующий его назначению и правам.
Изменение состояния и публикация события — две разные операции. Чтобы не потерять уведомление после успешной записи в базу, можно сохранять исходящее сообщение в той же локальной транзакции, а отправлять отдельным процессом. Такой подход называется transactional outbox. Доставка может повторяться, поэтому принимающая сторона должна распознавать уже обработанные сообщения. Этот механизм описан в каталоге архитектурных паттернов Microservices.io.
Порядок обработки задаем относительно конкретного объекта: например, одной сессии или одного платежного процесса. Глобальное упорядочивание всех сообщений обычно создает лишнее ограничение производительности. Если потребитель получил более новую версию состояния, старое событие не должно незаметно вернуть его назад. Правила обработки пропусков, поздних событий и конфликтующих версий входят в контракт подписки.
Необработанные сообщения направляются в отдельную очередь с причиной ошибки и контекстом для расследования. Само наличие такой очереди проблему не решает: нужны ответственный, срок реакции и контролируемый повтор. Повторная обработка исторических событий не должна заново отправлять неактуальные уведомления или создавать новые внешние операции. Для восстановления отчетных представлений можно использовать отдельный режим без побочных действий.
Событийная архитектура не означает обязательное применение event sourcing. Рабочее состояние может храниться в обычной базе, а события служить механизмом интеграции. Решение хранить историю событий как основную модель состояния принимается отдельно. Мы сначала определяем владельца факта, требования к восстановлению и жизненный цикл данных, затем выбираем брокер, правила хранения и способ построения производных представлений.
Архитектура Player Account Management
Player Account Management, или PAM, отвечает за учетную запись игрока и связанные с ней состояния. В общей архитектуре этот модуль связывает регистрацию, профиль, идентификацию и ограничения доступа. Другие компоненты используют устойчивый идентификатор игрока, а не собственные несогласованные копии его учетной записи. При этом финансовые операции и маркетинговые сценарии остаются в своих предметных областях.
Для PAM определяем, какие сведения он хранит самостоятельно, а какие получает от системы аутентификации, проверочного сервиса или операционной команды. Изменение критичного статуса должно доходить до зависимых компонентов в пределах согласованного времени. Для действий, требующих актуальной проверки, одного старого события или кешированной карточки недостаточно: нужен предусмотренный контрактом способ подтвердить действующие ограничения.
Модель доступа учитывает бренд, рынок и полномочия сотрудника. Объединение профилей, исправление сведений и блокировка сопровождаются объяснимой историей действий. Важно заранее определить поведение при временной недоступности PAM: какие операции можно продолжить, а какие требуется остановить до получения достоверного решения. В результате остальные сервисы получают стабильный интерфейс к состоянию игрока без знания внутренней структуры профиля. Подробные сценарии регистрации, жизненного цикла аккаунта и административного управления вынесены на страницу Player Account Management для iGaming.
Архитектура Wallet и Ledger
Wallet предоставляет интерфейс финансовых операций, а ledger хранит подтвержденные учетные записи о движении средств. В проектируемой системе авторитетный источник финансовой истории определяется однозначно: это согласованный журнал проводок, на основании которого можно проверить остаток. Отображаемый баланс, кеш и аналитический отчет являются представлениями и не должны независимо менять финансовое состояние.
На уровне архитектуры фиксируем владельца денежных операций, границу атомарности и правила конкурентного доступа. Повтор одной команды должен давать контролируемый результат без повторного списания. Связь между внешней операцией, внутренним идентификатором и учетными записями сохраняется для сверки. Исправления оформляются прослеживаемыми операциями; скрытая перезапись финансовой истории лишает систему возможности объяснить итоговый результат.
Доступный для использования остаток может учитывать резервы и другие состояния, поэтому его смысл описывается отдельно от простой суммы зачислений и списаний. Валюты, точность, разделение средств и допустимые переходы задаются в финансовой модели. При сетевом сбое неизвестный результат операции нельзя автоматически трактовать как отсутствие денежного эффекта. Для такой ситуации предусматриваем проверку состояния и последующую сверку. Здесь важны границы и связи финансового контура; подробная модель учета, проводки и сценарии резервирования описываются на странице Wallet и Ledger для iGaming-платформы.
Архитектура игровых интеграций
Игровые поставщики различаются форматами API, моделями сессии, идентификаторами раундов и поведением при ошибках. Чтобы эти различия не распространялись по всей платформе, между внешними системами и внутренними модулями создаем адаптационный слой. Он проверяет входящие сообщения, переводит их в согласованную модель и сохраняет исходные идентификаторы, необходимые для диагностики и сверки.
Каталог и транзакционные вызовы имеют разные требования. Метаданные игр можно обновлять фоновыми задачами, применять кеширование и публиковать после проверки. Запуск сессии требует проверки доступа и получения результата от поставщика. Финансовые сообщения требуют защиты от повторов и строгого сопоставления с внутренними операциями. Объединение этих потоков в одну неограниченную очередь создает риск, что обновление каталога задержит важный ответ.
Для каждой интеграции задаем собственные лимиты соединений, сроки ожидания и правила повторных запросов. Отказ одного поставщика не должен занимать все рабочие потоки приложения. Маршрутизация хранит связь сессии с конкретным источником; переключение агрегатора во время незавершенного раунда нельзя считать обычной заменой адреса API. Новый канал должен быть совместим со состоянием процесса и договоренностями сторон.
Доступность контента проверяется на сервере с учетом бренда, рынка, валюты и действующих ограничений. Скрытие карточки в интерфейсе недостаточно, потому что запрос запуска может поступить напрямую. Изменения каталога версионируются, а временное отключение провайдера отделяется от удаления его истории: завершенные и спорные операции должны оставаться доступными для расследования.
До выпуска проверяем контракт на тестовых примерах поставщика и на собственных сценариях: повтор сообщения, задержанный ответ, потеря соединения, неизвестный раунд и несогласованные параметры. Для поддержки готовим карту ошибок и способ найти операцию по внешнему идентификатору. Архитектура остается общей, а особенности конкретных протоколов сосредоточены внутри адаптеров. Подробнее о подключении API, каталога и сессий: интеграция игровых провайдеров.
Архитектура платежной инфраструктуры
Платежная инфраструктура объединяет пользовательские заявки, проверку условий операции, обмен с платежными провайдерами и получение окончательного результата. Центральный компонент управляет процессом, а адаптеры изолируют особенности поставщиков. Для каждого платежа сохраняются внутренний идентификатор, внешние ссылки, текущий статус и история переходов. Пользовательский экран получает состояние процесса из серверной системы, а не определяет успех по возвращению браузера на сайт.
Уведомления платежного провайдера могут задерживаться, повторяться и приходить в неожиданном порядке. Поэтому обработчик проверяет подлинность сообщения, сопоставляет его с созданной операцией и применяет допустимый переход состояния. Получение успешного уведомления не должно создавать второе зачисление, если операция уже была подтверждена другим каналом. Содержимое ответа и факт его приема сохраняются в пределах согласованной политики хранения.
Тайм-аут после отправки запроса требует осторожного решения. Поставщик мог принять платеж, даже если платформа не получила подтверждение. Автоматическое переключение на другого провайдера в таком состоянии может создать два независимых процесса. Сначала выясняем результат исходной операции через доступный канал проверки или сверку, затем принимаем решение о следующем действии. Правила различаются для создания заявки, подтверждения, отмены и возврата.
Маршрутизация учитывает поддерживаемые методы, валюты, рынки, техническую доступность и согласованные ограничения. Изменение маршрута должно быть объяснимым: сохраняем версию правила и причину выбора. Для вывода средств дополнительно фиксируем стадии проверки, резервирования, отправки и завершения. Отказ в одной стадии не должен незаметно превращаться в подтверждение другой.
Сверка сопоставляет внутренние операции с отчетами поставщика и выявляет расхождения по сумме, валюте, статусу и идентификатору. Это отдельный рабочий процесс с владельцем, очередью исключений и историей решений. Архитектура должна позволять обнаружить проблему даже тогда, когда все HTTP-запросы завершились технически успешно. Операционные отчеты строятся на подтвержденных состояниях, а промежуточные показатели маркируются соответствующим образом.
При подключении внешних платежных страниц стремимся уменьшить объем чувствительных данных, проходящих через платформу. Конкретная модель зависит от выбранного поставщика и требований проекта. Детали API, уведомлений, маршрутизации и обработки возвратов раскрыты на странице платежные интеграции для онлайн-казино.
High-load архитектура онлайн-казино
Высокая нагрузка определяется не только числом зарегистрированных игроков. Для расчета инфраструктуры нужны количество активных сессий, частота операций, распределение запросов по времени и доля обращений к внешним системам. Просмотр каталога, запуск игры и обработка транзакционного сообщения расходуют ресурсы по-разному. Поэтому модель нагрузки строится по сценариям, а не по одному усредненному показателю запросов в секунду.

Сначала измеряем путь запроса: время в приложении, ожидание соединений, обращения к базе и задержки интеграций. Определяем целевые значения для основных пользовательских действий и проверяем высокие перцентили, например p95 и p99. Среднее время ответа может оставаться приемлемым, даже когда заметная часть игроков сталкивается с длительным ожиданием. Отдельно считаем долю технических ошибок и бизнес-отказов.
Горизонтальное масштабирование приложения помогает, если экземпляры не зависят от локального состояния процесса. Пользовательские сессии, очереди задач и общие настройки требуют согласованного хранения. Однако добавление серверов не устраняет перегрузку базы данных. Иногда оно только увеличивает число конкурирующих соединений, поэтому лимиты пулов и возможности хранилища проверяются вместе с настройками автоматического масштабирования.
Кеширование применяем прежде всего к данным, для которых допустима ограниченная устарелость: изображениям, каталогу, локализации и справочникам. Для каждого кеша определяем время жизни и способ обновления. Проверки, влияющие на разрешение критичной операции, требуют отдельного подхода к актуальности. При одновременном истечении множества ключей нагрузка не должна обрушиваться на базу; обновление распределяется во времени и ограничивается по параллелизму.
Тяжелую отчетность переносим в отдельные представления и хранилища, чтобы длинные аналитические запросы не конкурировали с транзакционными операциями. Если требуется разделение данных, выбираем ключ с учетом реального распределения нагрузки. Один крупный бренд или активная группа игроков может создавать перегретый раздел даже при равномерном общем объеме. Поэтому план масштабирования включает измерение перекосов и процедуру перераспределения.
Нагрузочная проверка воспроизводит постепенный рост, резкий всплеск, длительную работу и восстановление после перегрузки. Нужны реалистичные пропорции сценариев и объемы данных, а также моделирование медленного провайдера. Результатом становится подтвержденный предел для согласованной конфигурации, запас ресурсов и перечень ограничений. Обещание неограниченного масштабирования заменяем измеряемыми условиями, при которых система сохраняет требуемое поведение.
Отказоустойчивость iGaming-платформы
Отказоустойчивость начинается с перечня сбоев, которые платформа должна переживать. Недоступность одного экземпляра приложения, потеря зоны размещения, задержка брокера и повреждение данных требуют разных механизмов. Для каждого критичного процесса определяем допустимое время восстановления и допустимую потерю данных. Эти параметры называют RTO и RPO; их согласуют с бизнесом и проверяют практическими упражнениями.
Резервирование экземпляров защищает от части инфраструктурных отказов, но не от ошибочного релиза, который одновременно распространяется на все копии. Поэтому выпуск выполняем поэтапно, наблюдаем за ключевыми показателями и сохраняем возможность остановить распространение. Изменения схемы данных проектируем совместимыми с промежуточными версиями приложения. Возврат предыдущего кода не гарантирует безопасный откат уже выполненной миграции.
Внешние зависимости изолируем отдельными лимитами и пулами ресурсов. Механизм circuit breaker временно ограничивает обращения к нестабильному сервису, а проверочные запросы помогают понять, когда можно восстановить поток. Повторы выполняются только для подходящих операций, с ограничением количества попыток и задержкой. Случайный разброс задержек уменьшает синхронные всплески повторной нагрузки; рекомендации по этому подходу приведены в AWS Well-Architected.
Деградация должна быть управляемой. При недоступности аналитики можно продолжать прием основных операций и временно задержать отчеты. При недостоверном решении о разрешении критичного действия выбирается более строгий сценарий. Игроку показывается понятный статус без ложного подтверждения успеха. Операционная команда видит причину ограничения и условия, при которых функция вернется в обычный режим.
Резервные копии проверяются восстановлением в изолированной среде. Важно восстановить не только таблицы, но и связанное состояние: конфигурацию, ключи доступа, позиции обработки сообщений и справочники. План описывает порядок действий, владельцев и проверки согласованности после запуска. Сам факт успешного создания копии еще не подтверждает, что платформа сможет возобновить работу в нужное время.
Межрегиональное резервирование требует отдельной оценки. Одновременная запись в нескольких регионах усложняет разрешение конфликтов и сохранение финансовых инвариантов. Для конкретного контура может быть предпочтителен один активный владелец записи с контролируемым переключением. Решение принимаем исходя из задержек, доступности и требований к данным, а затем проверяем на сценарии потери связи между площадками.
Observability и мониторинг
Observability позволяет восстановить картину происходящего по метрикам, журналам и распределенным трассировкам. Мониторинг отвечает на заранее заданные вопросы: доступен ли сервис, растет ли очередь, превышен ли порог ошибок. Наблюдаемость помогает исследовать новый сбой, когда его причина еще неизвестна. Для платформы нужны оба уровня, связанные с бизнес-операциями и понятными действиями поддержки.
Технические метрики включают задержку, число запросов, ошибки, использование ресурсов и насыщение пулов. Операционные показатели отражают успешность запуска игр, долю зависших процессов, возраст необработанных событий и расхождения сверки. Высокая доступность HTTP сама по себе недостаточна: сервис может возвращать корректные ответы, но не доводить операции до ожидаемого конечного состояния.
Идентификаторы корреляции связывают входной запрос, межсервисные вызовы, событие и ответ внешней системы. При расследовании сотрудник должен находить всю цепочку по идентификатору операции, не собирая вручную десятки несвязанных записей. Трассировка помогает различить время полезной работы и ожидание зависимости. Для асинхронных процессов сохраняем причинные связи, даже если обработка продолжается значительно позже исходного запроса.
Журналы имеют согласованную структуру и уровни важности. Пароли, токены, полные платежные реквизиты и документы не должны попадать в технические записи. Правила маскирования проверяются на реальных форматах сообщений. Доступ к логам ограничивается, а срок хранения определяется назначением данных. При этом финансовый аудит не подменяется диагностическими логами, которые могут выборочно собираться или удаляться по другой политике.
Оповещения связываем с влиянием на пользователей и обязательства сервиса. Для каждого сигнала назначаем ответственного, уровень срочности и инструкцию первичной проверки. Избыточное количество одинаковых уведомлений мешает заметить реальную проблему, поэтому группируем зависимые симптомы и учитываем технические работы. Отдельно контролируем саму систему наблюдаемости: отсутствие метрик может означать поломку сбора, а не отсутствие ошибок.
На приемке проверяем, можно ли обнаружить тестовый сбой, определить затронутые операции и подтвердить восстановление. Панель должна отвечать на практический вопрос команды: что перестало работать, насколько широко и с какого момента. Список графиков без таких сценариев не дает достаточной готовности к эксплуатации.
Безопасность архитектуры
Безопасность закладываем в границы доверия и права компонентов. Публичный интерфейс, сервер приложений, административный контур и внешние интеграции имеют разные полномочия. Запрос, прошедший входной шлюз, все равно проверяется целевым сервисом в контексте выполняемого действия. Наличие сетевого доступа не должно автоматически давать право читать данные другого бренда или менять состояние операции.
Пользовательские и служебные учетные записи разделяются. Сотруднику предоставляется доступ к нужным функциям, а критичные административные изменения могут требовать дополнительного согласования. Межсервисные учетные данные имеют ограниченную область применения и управляемый срок действия. Секреты хранятся в предназначенной для этого системе, а не в исходном коде, сборочных журналах или общих файлах конфигурации.
Внешние сообщения проверяются по согласованному протоколу: подлинность отправителя, целостность данных, допустимость времени и защита от повторного использования. Одной проверки IP-адреса обычно недостаточно как универсального механизма доверия. Входные параметры проверяются до изменения состояния. Сервер самостоятельно определяет разрешенный бренд и объект доступа, не полагаясь на идентификаторы, которые прислал клиент.
Персональные данные распределяются по назначению, с ограничением доступа и контролем выгрузок. Шифрование каналов и хранилищ дополняется управлением ключами и процедурой их замены. Для резервных копий и тестовых сред действуют отдельные правила: копирование рабочей базы не должно бесконтрольно расширять круг людей, имеющих доступ к чувствительным сведениям.
Перед реализацией рассматриваем сценарии злоупотребления: подмену контекста бренда, повтор команды, обход серверной проверки, чрезмерные полномочия сотрудника и компрометацию интеграции. Для каждого выбираем меры предотвращения, обнаружения и восстановления. Требования KYC/AML и обработки данных переводятся в технические сценарии на основании согласованных условий проекта. Детальное описание защитных механизмов и проверок вынесено на страницу безопасность iGaming-платформы.
Multi-brand и multi-market архитектура
Multi-brand означает поддержку нескольких брендов в общей платформе, а multi-market — работу с различающимися условиями рынков. Эти измерения связаны, но не взаимозаменяемы. Один бренд может работать в нескольких допустимых юрисдикциях, а один рынок обслуживаться несколькими брендами. Архитектура должна явно описывать эту связь, чтобы дизайн витрины не становился скрытым источником финансовых и операционных правил.
Для бренда определяем домен, оформление, каталог, коммуникации и настройки операционной команды. Для рынка — применимые ограничения, валюты, языки, доступные интеграции и требования к данным. Наследование конфигурации помогает переиспользовать общие настройки, но требует понятного приоритета правил. При диагностике должно быть видно, какое значение применилось, из какого уровня оно пришло и кто его изменил.
Контекст арендатора проходит через API, фоновые задачи, сообщения и запросы к данным. Его проверяют на сервере, а права сотрудника ограничиваются разрешенными областями. Изоляция может обеспечиваться на уровне строк, схем, отдельных баз или выделенных развертываний. Выбор зависит от требований к разграничению, стоимости эксплуатации и допустимого общего радиуса отказа.
Общие ресурсы требуют контроля справедливого распределения. Всплеск активности одного бренда не должен вытеснить операции остальных из очередей и пулов соединений. Для этого предусматриваем квоты, приоритеты и раздельные лимиты. Аналитика может объединять показатели только там, где это разрешено моделью доступа и назначением отчета; интерфейс фильтрации сам по себе не является защитой данных.
Изменения конфигурации проходят валидацию и поэтапное включение. Ошибка в общем шаблоне способна затронуть все бренды, поэтому полезны предварительный просмотр итоговых настроек, контроль обязательных полей и возможность вернуть предыдущую версию. Существующие операции продолжают использовать закрепленные для них условия, если бизнес-правила требуют стабильности на протяжении жизненного цикла.
Запуск нового рынка рассматриваем как управляемое расширение платформы. Проверяем матрицу доступных функций, интеграций, локализации и хранения данных, затем выполняем сквозные сценарии на целевой конфигурации. Универсальная кодовая база уменьшает повторную разработку, но не отменяет различий рынков. Поэтому архитектура должна позволять выразить исключения явно, без копирования всего приложения для каждой новой комбинации условий.
Как проектируем архитектуру iGaming-платформы
Проектирование начинаем с рабочих сценариев и ограничений. Уточняем состав первой версии, план развития, существующие системы и доступность документации поставщиков. Вместе с командой заказчика определяем критичные процессы и критерии их успешности. Если платформа уже работает, изучаем фактические зависимости и данные наблюдаемости: документированная схема может отличаться от того, как запросы проходят через систему на практике.
- Собираем требования. Фиксируем роли, рынки, бренды, интеграции, профиль нагрузки и ограничения эксплуатации.
- Определяем границы. Назначаем владельцев данных, команд и бизнес-процессов, описываем доверие между компонентами.
- Проектируем взаимодействие. Согласуем API, события, состояния, ошибки и правила повторной обработки.
- Проверяем риски. Разбираем отказ зависимостей, конкурентные действия, восстановление и изоляцию данных.
- Планируем реализацию. Разбиваем работу на проверяемые этапы и определяем критерии приемки каждого результата.
Ключевые решения оформляем с контекстом: какую проблему решаем, какие варианты рассмотрены и какие последствия принимаем. Это помогает новым участникам понять, почему выбран определенный способ хранения или взаимодействия. Фиксируем не только целевую схему, но и допущения. Если прогноз нагрузки или состав команды меняется, можно проверить конкретное решение, а не начинать обсуждение всей архитектуры заново.
Для наиболее рискованных предположений создаем ограниченные технические прототипы. Это может быть проверка задержки интеграции, конкурентной обработки команд или скорости восстановления из резервной копии. Прототип отвечает на конкретный вопрос и имеет измеримый критерий. Его задача — снять неопределенность до масштабной реализации, а не незаметно превратиться в рабочую систему без необходимых эксплуатационных механизмов.
Для действующей платформы составляем переходный план. Определяем, как совместить старые и новые интерфейсы, перенести данные, проверить результаты и переключить поток операций. На время миграции заранее назначаем авторитетный источник состояния. Параллельное чтение или теневое сравнение ответов может помогать проверке, но неконтролируемая двойная запись увеличивает риск расхождений и требует отдельного обоснования.
Результатом становятся схема компонентов и развертывания, описание контрактов, модель состояний, требования к наблюдаемости и план восстановления. Состав документации и глубину детализации согласуем по проекту. Архитектура считается готовой к реализации, когда команда может оценить этапы, воспроизвести основные сценарии и проверить принятые ограничения. После запуска решения пересматриваем по измерениям и реальным потребностям развития продукта.
Ответы на часто задаваемые вопросы
Из каких модулей состоит iGaming-платформа?
Обычно платформа включает клиентский интерфейс, PAM, финансовый контур, игровые и платежные интеграции, управление каталогом, Bonus Engine, CRM, KYC/AML и back office. Их работу поддерживают события, аналитика и инфраструктура. Конкретный состав зависит от продукта: часть возможностей может обеспечиваться внешними сервисами. Главное — определить владельца каждого состояния и не допускать конфликтующих источников данных.
Нужны ли микросервисы для онлайн-казино?
Не обязательно. Для небольшой команды и согласованного цикла выпуска подходит модульный монолит с четкими внутренними границами. Микросервисы полезны, когда нужны независимые релизы, масштабирование отдельных областей или изоляция интеграций. Переход должен опираться на измеренную проблему и готовность эксплуатации. Само разделение приложения на множество процессов не гарантирует ни скорости разработки, ни надежности.
Как должен быть устроен wallet?
Wallet должен предоставлять контролируемый интерфейс операций, учитывать конкурентные запросы и исключать повторный денежный эффект одной команды. Его связь с учетным журналом и правила определения доступного остатка фиксируются явно. Подробности зависят от финансовой модели. Основные принципы и сценарии разобраны на странице Wallet и Ledger.
Что является source of truth для баланса?
В предлагаемой архитектуре подтвержденная финансовая история хранится в ledger. Баланс должен быть согласован с этой историей и правилами учета резервов. Кеш, интерфейс игрока и аналитическое хранилище используют производные данные. Для каждого вида остатка требуется четкое определение, чтобы разные сервисы не выдавали разные значения под одним названием.
Как масштабировать казино при росте нагрузки?
Сначала измеряют узкие места и профиль операций, затем выбирают действие: увеличивают ресурсы приложения, оптимизируют запросы, отделяют отчетность, применяют кеширование или разделяют потоки обработки. Добавление экземпляров без учета ограничений базы может усилить перегрузку. Эффект проверяется нагрузочным испытанием с реалистичными сценариями, всплесками трафика и задержками внешних зависимостей.
Как изолировать сбой игрового провайдера?
Для провайдера выделяют адаптер, ограничивают параллелизм, время ожидания и количество повторов. При устойчивых ошибках временно ограничивают новые обращения, сохраняя возможность выяснить результат ранее начатых операций. Каталог и сессии других поставщиков продолжают работать в пределах независимых ресурсов. Автоматическое переключение незавершенного раунда допустимо только при предусмотренной совместимости процесса.
Как устроить аудит транзакций?
Нужно связать исходную команду, внутреннюю операцию, учетные записи и внешние подтверждения устойчивыми идентификаторами. Сохраняются время, участник действия, результат и основание корректировки. Доступ к истории ограничивается, изменения отслеживаются, а расхождения выявляются сверкой. Аудит должен позволять объяснить итог операции после сбоя; обычных технических логов с коротким сроком хранения для этого недостаточно.
Нужна архитектура новой платформы или план развития существующей системы? Опишем границы модулей, критичные зависимости и этапы реализации под ваши задачи.