Техническая поддержка и сопровождение iGaming-платформ
После запуска платформа требует постоянного внимания: нужно отслеживать ошибки, поддерживать интеграции, выпускать обновления и готовить инфраструктуру к росту нагрузки. Casino Game помогает выстроить сопровождение с понятными зонами ответственности, приоритетами и отчетностью.
Что входит в техническое сопровождение iGaming-платформ
Состав работ формируем после знакомства с архитектурой, инфраструктурой и задачами оператора. В договоре фиксируем обслуживаемые компоненты, доступные среды, ответственность команды заказчика и внешних поставщиков.
Мониторинг работоспособности
Настраиваем проверки доступности сайта, API и ключевых пользовательских сценариев. Собираем метрики, логи и уведомления, чтобы замечать отклонения до массовых обращений пользователей. Для каждого сигнала определяем порог и ответственного.
Управление инцидентами и сбоями
Регистрируем событие, оцениваем влияние на платформу и назначаем приоритет. Координируем диагностику, восстановление и взаимодействие с поставщиками. После значимых сбоев разбираем причины и формируем меры против повторения.
Оперативное исправление ошибок
Воспроизводим дефект, проверяем затронутые сценарии и готовим исправление. Критические ошибки обрабатываем по процедуре аварийного релиза, остальные включаем в согласованный план. Проверяем результат на тестовой среде и после установки.
Выпуск обновлений и новые релизы
Поддерживаем зависимости, конфигурации и компоненты платформы. Перед выпуском оцениваем совместимость, выполняем проверки и готовим план отката. Время работ и возможное влияние на пользователей согласуем заранее.
Подключение новых провайдеров и интеграций
Изучаем документацию API, настраиваем тестовую среду и проверяем обмен событиями. Согласуем состав сценариев, ограничения поставщика и критерии приемки. Новые подключения оцениваем отдельно, если они не входят в пакет сопровождения.
Гарантии и SLA технической поддержки
SLA — соглашение об уровне сервиса: оно определяет порядок обработки обращений, целевые показатели и способ их измерения. До начала работ согласуем перечень сервисов и границы ответственности.
Режим сопровождения и время реакции определяются договором. Круглосуточная поддержка, работа в выходные и конкретные сроки действуют только при включении в согласованные условия.
Уровни критичности проблем
Приоритет зависит от влияния на пользователей, операции и целостность данных. Критическим может быть полный отказ платформы или нарушение учета транзакций; высоким — недоступность значимой функции; обычным — локальная ошибка с обходным решением. Классификацию и порядок изменения приоритета фиксируем в SLA.
Гарантированное время реакции
Для каждого приоритета согласуем срок подтверждения обращения и начала диагностики, часы обслуживания и момент начала отсчета. Время реакции не равно времени устранения: восстановление зависит от причины, доступов и внешних сервисов. Целевые сроки восстановления и условия их применения указываем отдельно.
Прозрачный процесс эскалации
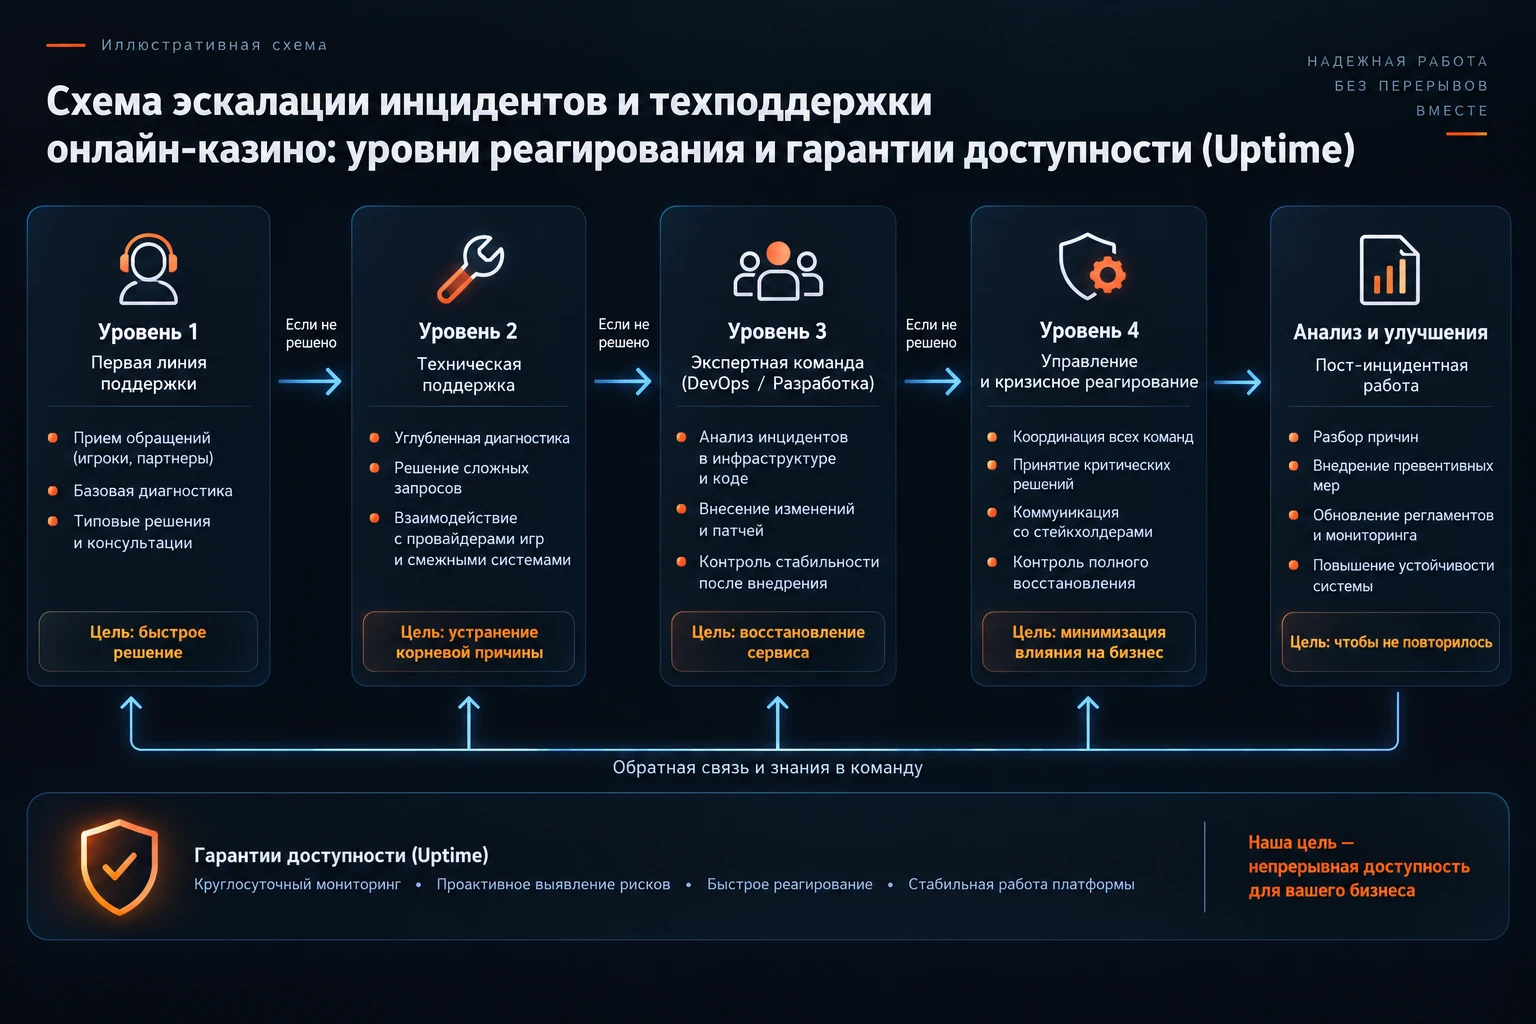
Определяем, когда обращение переходит от дежурного специалиста к профильному инженеру, техническому руководителю или поставщику. В регламенте закрепляем контакты, полномочия и действия при недоступности ответственного.
Коммуникация и регулярная отчетность
Используем согласованный канал обращений и единый журнал задач. В ходе инцидента сообщаем статус и следующий шаг с установленной периодичностью. В отчете показываем обращения, соблюдение SLA, выполненные работы, повторяющиеся проблемы и рекомендации.
Мониторинг инфраструктуры
Объединяем технические метрики с проверками значимых для бизнеса сценариев. Разделяем предупреждения и аварийные сигналы, чтобы команда могла сосредоточиться на событиях, требующих вмешательства.
Концепт интерфейса
Мониторинг приложений
Отслеживаем доступность API, долю ошибок, время ответа, очереди задач и фоновые процессы. Связываем логи и трассировки запросов для диагностики; ограничиваем попадание персональных данных и секретов в журналы.
Инфраструктура
Контролируем загрузку процессоров, память, диски, сеть, базы данных и контейнеры. Проверяем сроки сертификатов, состояние репликации и запас ресурсов. Пороги уведомлений учитывают обычную нагрузку конкретной платформы.
Транзакции
Наблюдаем за задержанными операциями, расхождениями статусов и результатами сверки. Настраиваем сигналы о нетипичной доле ошибок и зависших обработчиках. Доступ к финансовым данным предоставляем по ролям с журналированием действий.
Интеграции
Проверяем доступность внешних API, таймауты, ответы с ошибками и доставку уведомлений. Различаем сбой платформы и недоступность поставщика, чтобы направить запрос нужной команде и выбрать допустимый сценарий восстановления.
Управление инцидентами
Для аварийных ситуаций готовим инструкции с проверяемыми шагами и контактами ответственных. Работа с инцидентом включает:
Иллюстративная схема
Регистрацию сигнала, оценку масштаба и назначение приоритета.
Диагностику по метрикам, журналам и последним изменениям.
Локализацию проблемы и согласованное восстановление: откат, переключение или исправление.
Проверку пользовательских сценариев и корректности операций.
Разбор причин, отчет и задачи по предотвращению повторного сбоя.
Опасные для данных действия согласуем с ответственным со стороны заказчика. Временное восстановление сервиса и окончательное устранение причины отслеживаем как отдельные результаты.
Обновления безопасности
Ведем перечень используемых компонентов и оцениваем применимость обновлений безопасности. Приоритет учитывает наличие уязвимого компонента в рабочей среде, доступность извне и возможное влияние на данные.
Проверяем патчи на тестовом контуре, готовим резервную копию и план отката, устанавливаем обновления в согласованное окно. По результатам подтверждаем версии и работоспособность сервисов. Аудит безопасности и отдельное тестирование на проникновение согласуем как самостоятельные работы.
Поддержка игровых интеграций
Сопровождаем запуск игровых сессий, обмен событиями раундов, обновление каталога и взаимодействие с кошельком. Проверяем подписи запросов, повторную доставку событий и корректное завершение операций после прерывания связи.
При изменениях API обновляем адаптеры и выполняем регрессионные проверки. Для обращения к провайдеру собираем технические идентификаторы и обезличенные диагностические сведения. Подключение контента выполняем с учетом согласованных рынков и условий поставщика.
Поддержка платежной инфраструктуры
Поддерживаем технические интеграции с платежными поставщиками: запросы, уведомления, статусы и сверку операций. Разбираем зависшие платежи, ошибки обработки и расхождения между данными платформы и провайдера.
Проверяем защиту от повторного учета одной операции, обработку таймаутов и восстановление после сбоев. Повторные запросы выполняем с учетом статуса у поставщика. Изменения финансовых записей проходят согласованный контроль и сохраняются в журнале; решения по выплатам остаются в зоне ответственности оператора.
Оптимизация производительности
Определяем узкие места по измерениям: времени ответа, медленным запросам к базе, очередям и потреблению ресурсов. Согласуем целевые показатели и профиль нагрузки, затем проверяем гипотезы на тестовой среде.
Оптимизируем запросы, индексы, кеширование и фоновые задачи, корректируем масштабирование. Сравниваем показатели до и после изменений при сопоставимой нагрузке. Перед крупными акциями или ростом аудитории планируем нагрузочные испытания и резерв мощности.
Управление релизами и CI/CD
Выстраиваем воспроизводимый путь от изменения кода до установки в рабочую среду. CI/CD автоматизирует сборку, проверки и доставку; доступ к выпуску и подтверждение значимых изменений закрепляем за ответственными.
Разделяем среды разработки, тестирования и эксплуатации.
Запускаем согласованные автоматические и ручные проверки.
Проверяем миграции базы данных и совместимость версий.
Готовим описание релиза, окно установки и план восстановления.
После выпуска наблюдаем за метриками и ключевыми сценариями.
Если миграция не допускает простого отката, заранее согласуем иной способ восстановления и необходимые ограничения на время работ.
Резервное копирование и аварийное восстановление
Определяем, какие базы, файлы и конфигурации нужно сохранять, с какой периодичностью и на какой срок. Настраиваем контроль успешности копирования, ограничение доступа и хранение копий отдельно от основной среды.
Согласуем RPO — допустимый период потери данных — и RTO — целевое время восстановления. Проверяем восстановление на отдельном контуре: наличие копии само по себе не подтверждает ее пригодность. Результаты проверок и порядок действий при аварии включаем в эксплуатационную документацию.
Изменения регуляторных требований
На основании требований, подтвержденных юридической и комплаенс-командой заказчика, оцениваем необходимые изменения платформы. Они могут затрагивать идентификацию, лимиты, самоисключение, территориальные ограничения, журналы событий и отчетность.
Переводим согласованные требования в технические задачи, определяем зависимости, сроки и критерии приемки. Реализуем и проверяем изменения, готовим технические материалы для заказчика. Юридическое толкование требований и разрешение на работу на конкретном рынке остаются за уполномоченными специалистами оператора.
Развитие платформы после запуска
Формируем план развития по обращениям команды оператора, данным мониторинга и продуктовым задачам. Отдельно учитываем технический долг, новые функции и улучшение эксплуатационных процессов.
Для каждой инициативы оцениваем ожидаемый результат, трудоемкость, риски и зависимости. Приоритеты согласуем с заказчиком, работу разбиваем на проверяемые этапы. Объем разработки новых модулей и интеграций закрепляем в плане или отдельной оценке.
Подключение существующей платформы к сопровождению
Возможность сопровождения платформы другой команды определяем после технического обследования. Для оценки нужны описание архитектуры, стек, перечень интеграций, документация, сведения о нагрузке и текущих проблемах.
Уточняем состав системы, права на код и условия доступа.
Изучаем сборку, развертывание, инфраструктуру и состояние резервных копий.
Фиксируем выявленные ограничения и необходимые подготовительные работы.
Согласуем границы ответственности, SLA, каналы связи и бюджет.
Принимаем доступы безопасным способом, подключаем мониторинг и проверяем процедуры восстановления.
Дату начала обязательств по SLA закрепляем после согласованной приемки. Если исходный код или доступы к поставщикам отсутствуют, отдельно определяем доступный объем поддержки.
Стоимость поддержки
Стоимость рассчитываем по составу системы и требуемому уровню сервиса. На бюджет влияют режим работы команды, приоритеты и время реакции, количество сред и интеграций, нагрузка, состояние документации и объем плановых изменений.
В предложении разделяем регулярное сопровождение, первичный аудит и подключение, дополнительные доработки и расходы на внешние сервисы. Оплату инфраструктуры, лицензий и услуг провайдеров учитываем отдельно, если договором не предусмотрено иное.
Для оценки пришлите описание платформы, список компонентов, текущие проблемы и желаемый режим поддержки. После обследования подготовим состав работ, допущения и порядок согласования задач сверх включенного объема.
Можно ли передать вам платформу другого разработчика?
Да, возможность и объем сопровождения определяем после обследования. Проверяем доступность кода, документации, инфраструктуры и тестовых сред, затем согласуем подготовительные работы и приемку.
Работает ли поддержка круглосуточно?
Режим сопровождения определяется договором. Если требуется работа 24/7, отдельно согласуем дежурства, обслуживаемые компоненты, каналы обращений и условия реакции вне рабочего времени.
Как быстро будет устранена ошибка?
Время реакции устанавливаем в SLA для каждого приоритета. Срок устранения зависит от причины и внешних зависимостей; после диагностики сообщаем план и оценку. Целевые сроки восстановления согласуем отдельно.
Входят ли новые функции в сопровождение?
Это зависит от согласованного объема. Исправление дефектов, эксплуатационные работы и развитие учитываем отдельно. Новые модули и подключения включаем в план только после оценки и согласования.
Кто взаимодействует с игровыми и платежными провайдерами?
Порядок взаимодействия закрепляем при подключении. При наличии необходимых полномочий команда поддержки ведет техническую диагностику с поставщиком; договорные и финансовые вопросы решает оператор.
Как контролировать выполненные работы?
Предоставляем согласованный доступ к журналу задач и регулярные отчеты. Фиксируем обращения, приоритеты, сроки реакции, установленные изменения и открытые риски; периодичность отчетности определяем в договоре.